ホーム/展示装置/デジタル・AI/ビジョンファンデーションモデル

ビジョンファンデーションモデル

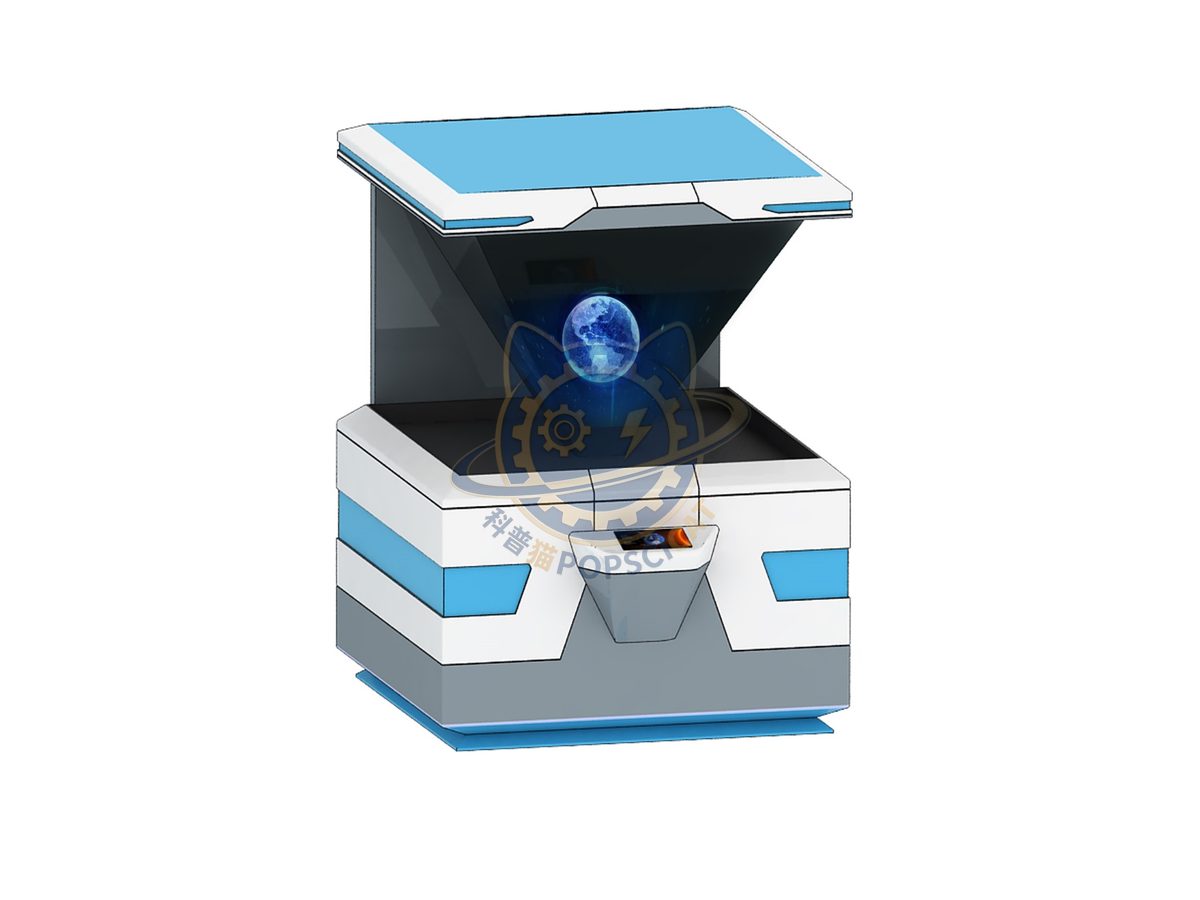
視覚的なビッグモデルは、視覚情報を理解し、解釈するために設計された人工知能モデルです。

ビジョンファンデーションモデル — デジタル・AI 科学館向け展示装置
参考画像
カテゴリーデジタル・AI
標準寸法寸法特注
消費電力100–240 V AC、50/60 Hz、単相 — ユニバーサル入力。降圧トランスもモーターの再結線も不要です
電源1 台から量産まで · 図面による OEM 対応
納期手付金のお支払い後 3〜6 週間(契約ごとに確定)
保証構造・制御ともに 1 年
図面・資料仕様書・制御図・補修部品リスト

カタログ標準モデルです。寸法、制御パッケージ、仕上げが確定しているからこそ、価格と納期を見通せます。サイズ、色、表示言語は、新たな設計工程を挟まずに変更できます。
このモデルについて問い合わせる → メールで問い合わせる

このシリーズの標準モデルは自社オンラインストアにも USD 価格で掲載しています — 価格を直接ご確認ください ↗

01 / 概要

視覚的なビッグモデルは、視覚情報を理解し、解釈するために設計された人工知能モデルです。さまざまなデータセットから階層構造を自動的に学習し、複雑なパターンやコネクションを画像で検出することができます。

02 / 来館者の使い方

ユニットは、監視されていない公共使用のために設計されています:制御は、凹凸またはシールドされ、可動部分が封じられ、インターフェイスは、指示なしで約6の子供の操作可能です。画面が使用される場合、ハードウェアを変更することなく言語を切り替えることができ、コンテンツはサイトに置き換えることができます。

03 / 原理

深層学習モデルや視覚トランスとしても知られる視覚的なビッグモデルは、近年の人工知能技術の高度に予想される技術面で、特にコンピュータビジョンの分野において大きな可能性を秘めています。視覚的なビッグモデルは、視覚情報を理解し、解釈することを目的とした人工知能モデルの一種です。ビッグビジュアルモデルは、ディープラーニングの原則に基づいて運営し、視覚的なコンテンツを分析し理解するために、多数のパラメータでニューラルネットワークを利用しています。幅広いデータセットから階層構造を自動的に学習し、大きなビジュアルモデルが複雑なパターンや画像の接続を検出できるようにしました。視覚的な大きなモデルは、ニューラルネットワークアーキテクチャ、特にトランスアーキテクチャに基づいています。これは、2つの部分で構成されます。自己の注意メカニズムと位置のエンコーディング。自己の注意メカニズムは、モデルが入力データの重要な部分に焦点を合わせることを可能にしますが、位置のエンコーディングは、モデルがイメージの要素の位置関係を理解するのに役立ちます。これらの2つの部分を通して、視覚的な大きいモデルは捕獲できます。

04 / 公共空間での耐久設計

すべての装置は試運転を経て工場を出ます。機構は往復動作を繰り返し、電子部品はエージングし、エッジは面取りし、締結部は規定トルクで締めてマーキングします。ベアリング、スライダー、ランプ、ベルト、タッチパネルなどの消耗部品はモジュール化し、補修部品リストに記載しているので、施設の技術者が装置を返送せずに交換できます。梱包は合板ケースに発泡ブロック止め。積載図とパッキングリストは出荷に同行します。

同カテゴリー

デジタル・AI のその他のモデル

デジタル・AIシリーズの他のモデル。いずれも同じ仕様、同じ制御パッケージで製作しています。

プロジェクトを始める

展示装置リストをお送りください。
価格をご案内します。

テーマの概要、平面図、あるいは何も添付せずに、空間の写真 1 枚だけでも始められます。お見積りは実際の展示装置リストに基づいて作成し、平米あたりの概算では出しません。

ご発注前に工場をご覧になりませんか。 工場見学、第三者検査も歓迎します。

お見積り依頼 →
[email protected] +86 133 0169 0619 1 営業日以内にご返信します。
WhatsApp QR コード — スキャンして Shanghai Inertia とチャット
WhatsAppスキャンしてチャット
WeChat QR コード — スキャンしてメッセージ
WeChatスキャンして友だち追加