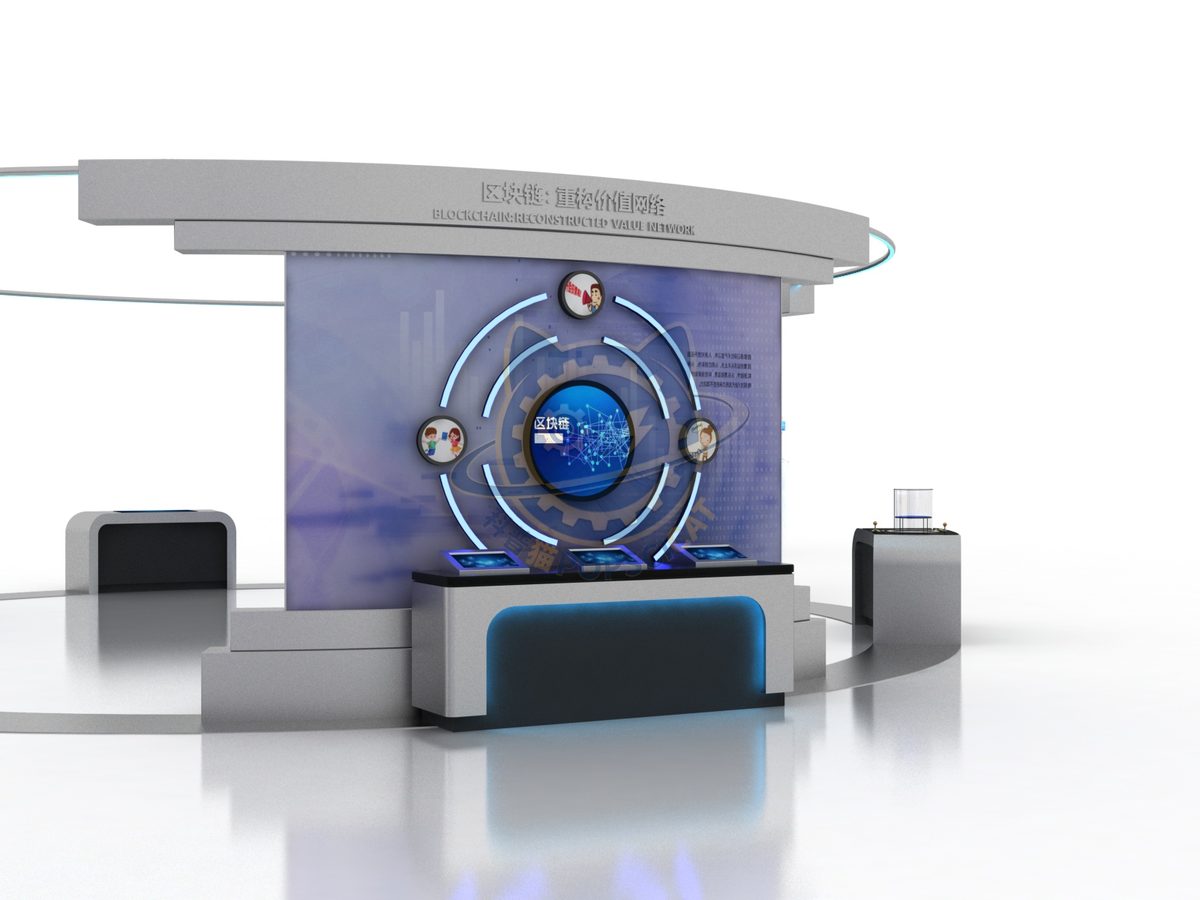
| カテゴリー | デジタル・AI |
|---|---|
| 標準寸法 | 寸法特注 |
| 消費電力 | 100–240 V AC、50/60 Hz、単相 — ユニバーサル入力。降圧トランスもモーターの再結線も不要です |
| 電源 | 1 台から量産まで · 図面による OEM 対応 |
| 納期 | 手付金のお支払い後 3〜6 週間(契約ごとに確定) |
| 保証 | 構造・制御ともに 1 年 |
| 図面・資料 | 仕様書・制御図・補修部品リスト |
カタログ標準モデルです。寸法、制御パッケージ、仕上げが確定しているからこそ、価格と納期を見通せます。サイズ、色、表示言語は、新たな設計工程を挟まずに変更できます。
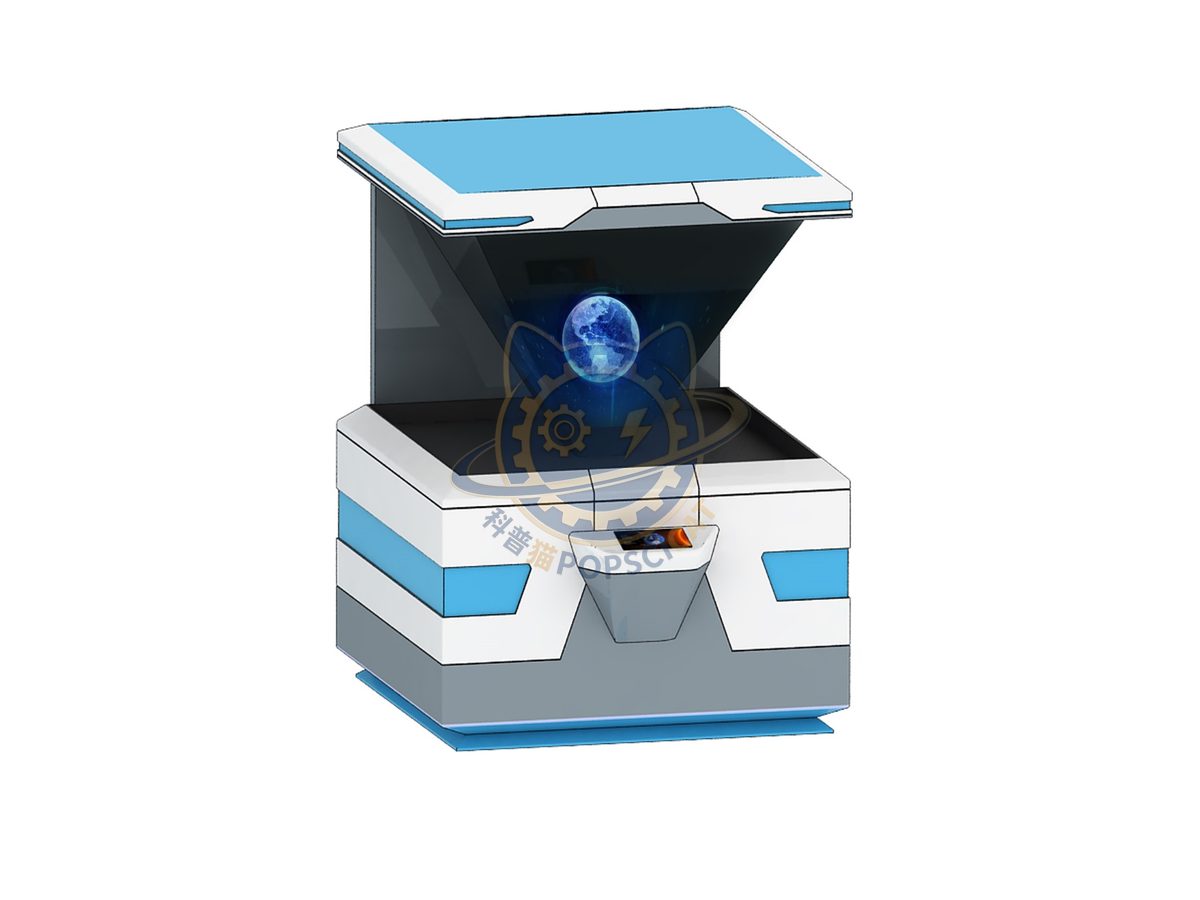
スピーチ認識は、音声をテキストに自動的に変換するプロセスです。つまり、機械が対応するテキストやコマンドに人間のスピーチ信号を認識し理解できるようにします。音声信号処理、機能抽出、音響モデリング、言語モデリング、デコーダなど、複数のキーステップと技術コンポーネントを含みます。音声認識技術は、カーナビゲーション、スマートホーム、毎日のオフィスワークなどの分野で広く使用され、人々の仕事や生活に多くの利便性をもたらします。
ユニットは、監視されていない公共使用のために設計されています:制御は、凹凸またはシールドされ、可動部分が封じられ、インターフェイスは、指示なしで約6の子供の操作可能です。画面が使用される場合、ハードウェアを変更することなく言語を切り替えることができ、コンテンツはサイトに置き換えることができます。
スピーチ認識技術の原則は、人間のスピーチ信号をコンピュータによって処理することができる言語形態に変換し、最終的にテキストや指示としてそれらを出力することとして要約することができます。このプロセスは、主に音信号処理、特徴抽出、音響モデル、言語モデル、デコーダを含む複数の主要なステップと技術的なコンポーネントを含みます。音信号処理:まず、元のスピーチ信号を前処理して、環境騒音やエコーなどの干渉要因を排除します。このステップは通常、ノイズリダクションや強化などの操作を含み、その後の処理の信号品質を確保します。スピーチ信号の開始点と終了点を検知し、サイレントセグメントや無用信号を削除し、効果的なスピーチ部分を保持します。これは、計算された複雑性を減らし、認識の効率を改善するのに役立ちます。特徴の抽出:前処理されたスピーチ信号を一連の特徴のベクトルに変換し、音声信号の音響特性を記述できます。一般的な機能抽出方法には、短時間Fourier変換(STFT)とMel周波数Cepstrumが含まれます。
すべての装置は試運転を経て工場を出ます。機構は往復動作を繰り返し、電子部品はエージングし、エッジは面取りし、締結部は規定トルクで締めてマーキングします。ベアリング、スライダー、ランプ、ベルト、タッチパネルなどの消耗部品はモジュール化し、補修部品リストに記載しているので、施設の技術者が装置を返送せずに交換できます。梱包は合板ケースに発泡ブロック止め。積載図とパッキングリストは出荷に同行します。
デジタル・AIシリーズの他のモデル。いずれも同じ仕様、同じ制御パッケージで製作しています。
テーマの概要、平面図、あるいは何も添付せずに、空間の写真 1 枚だけでも始められます。お見積りは実際の展示装置リストに基づいて作成し、平米あたりの概算では出しません。
ご発注前に工場をご覧になりませんか。 工場見学、第三者検査も歓迎します。